卓驭起步于 2016 年,致力于成为国际一流的移动物理 AI 公司。依托独有的原生多模态基础模型和生成式 AI 技术,打造可高效适配多场景的统一移动智能技术底座,不仅为车企提供开放、可定制、量产导向的智能辅助驾驶(涵盖 L2 及以上)解决方案,更致力于为不同场景下的自主移动机器人提供底层技术,实现从地面到近地空间的全域智能移动生态赋能。
随着研发规模扩大,训练和推理算力逐步走向多数据中心、混合云,数据规模和访问需求也持续增长。计算资源可以按需调度,但任务启动仍可能受挂载状态、数据回源和模型加载影响。如何让数据及时就绪、减少算力等待,成为存储架构演进的重要目标。
卓驭基于 JuiceFS 构建统一数据底座,通过统一访问、多存储池和共享缓存,支撑数据接入、容量扩展与热点复用,再结合主动预热和读取优化,加快数据交付。目前,线上集群已承载百 PB 级数据,在线读取能力达到百 GB/s 量级。本文将围绕架构演进与生产实践展开。
01 智驾数据闭环:容量持续增长,数据反复消费
智能辅助驾驶的研发围绕数据闭环展开:路采车和量产车回传的数据经过筛选、标注,进入模型训练,再经过评测与发布;新问题和新数据又进入下一轮迭代。在这个过程中,数据在每个环节的就绪速度,直接影响算力是否需要等待,也影响研发效率。
从存储角度看,智驾研发是一条数据密集型链路,多模态数据持续回流,并被不同研发任务反复消费。量产车和路采车回传的数据,加上仿真产出的数据,首先进入共享的多模态数据存储,再由筛选、标注、模型训练、仿真评测和个人研发环境等下游任务使用。
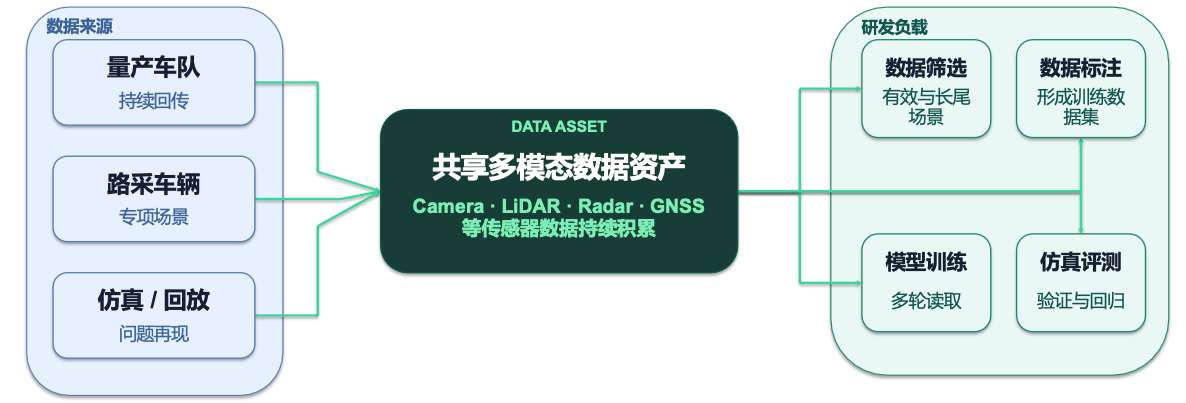
随着数据规模和迭代频次增长,存储需要同时支撑持续扩容与高效读取,才能及时向下游任务交付数据。
02 原有架构中的访问、运维与扩展耦合
引入 JuiceFS 之前,我们同时使用 S3 接口和文件访问,多种入口并存,存储配置分散在业务侧,挂载客户端则由计算侧维护。
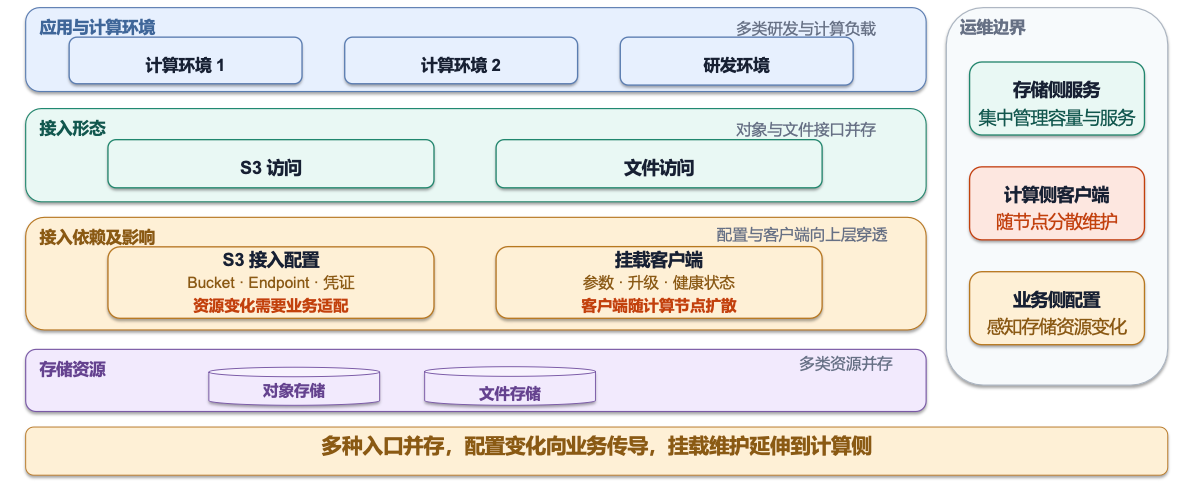
由此我们归纳出三类核心痛点:
- 挂载与调度耦合:任务启动依赖挂载客户端就绪,客户端维护延伸到计算侧,增加运维负担,并可能造成算力等待;
- 存储配置与业务耦合:Bucket、Endpoint、凭证等存储细节进入业务代码,底层资源变化需要业务配合调整;
- 容量与带宽扩展耦合:容量持续增长,热点数据反复读取,本地缓存难以跨节点复用,容量与读取带宽难以按需独立扩展。
因此,新架构需要简化业务接入和挂载维护,并支持容量与读取带宽独立扩展。
03 架构升级:基于 JuiceFS 构建统一数据底座
技术选型:以 S3 为核心,JuiceFS 为底座
为兼容存量业务并支撑后续扩展,我们选择 JuiceFS 作为存储底座,主要考虑以下四点:
- 多协议访问:支持 S3、POSIX 等接口,兼容不同业务的接入方式。
- 容量扩展:底层依托对象存储,承载持续增长的数据。
- 缓存加速:社区版已有本地缓存能力,可作为后续读取优化的基础。
- 开源生态:社区活跃,便于结合生产需求持续改进。
统一访问层:应用与存储解耦
新架构中,业务通过内部数据平台的 SDK 访问存储。SDK 提供统一的逻辑命名空间,并处理底层存储位置与访问凭证的映射。通过 SDK 接入的业务以 S3 访问为主,减少计算侧的挂载维护;存量业务仍可使用 POSIX 接口。
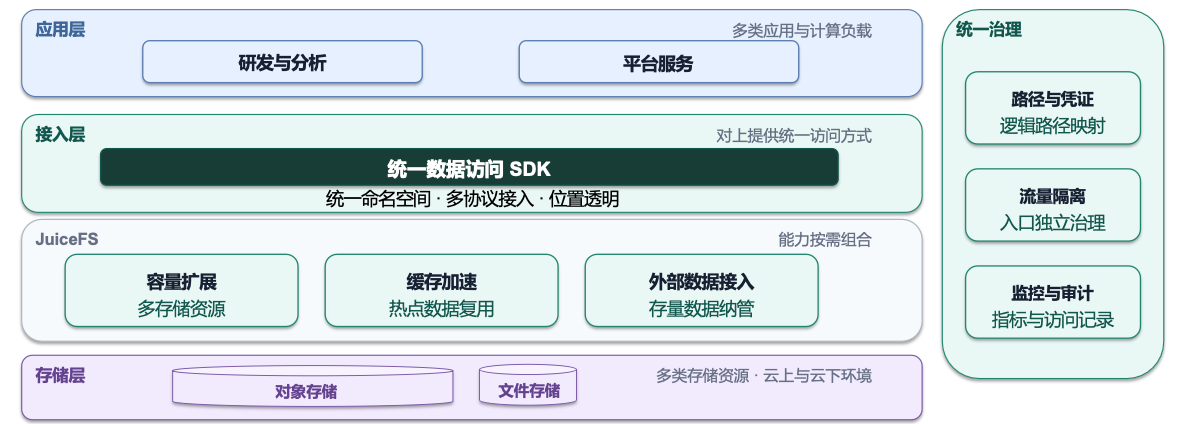
以 S3 为核心的接入方式,也方便我们在入口进行流量隔离、监控和审计。
统一访问层将应用与存储的变化分开,减少底层资源调整对业务接入的影响。在保持上层接口稳定的同时,我们可以继续扩展容量、增加缓存和接入外部数据。
04 核心能力构建
我们基于 JuiceFS 社区版扩展了多存储池、分布式缓存和 UFS,整体架构如下。
多存储池:容量扩展与故障隔离
我们在 JuiceFS 单卷的数据层增加路由,根据文件大小、权重等策略,将写入分配到不同存储池。后端可以是多个 S3 Bucket,也可以是文件存储。
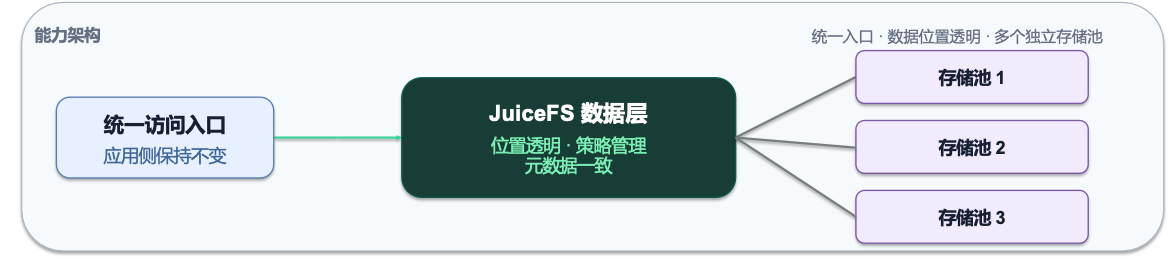
这样,JuiceFS 卷与 Bucket 形成一对多关系。当某个对象存储资源达到扩展边界时,可以增加存储池承接后续写入,已有数据不必整体搬迁。多个独立存储池也有助于缩小单一资源域故障的影响范围。
分布式缓存:跨节点复用热点数据
初期我们使用本地缓存,节点之间无法复用缓存数据。任务调度到新节点后,如果本地没有所需数据,就需要再次回源,并在该节点保留一份副本。这既增加读取时延,也降低了缓存空间的利用率。
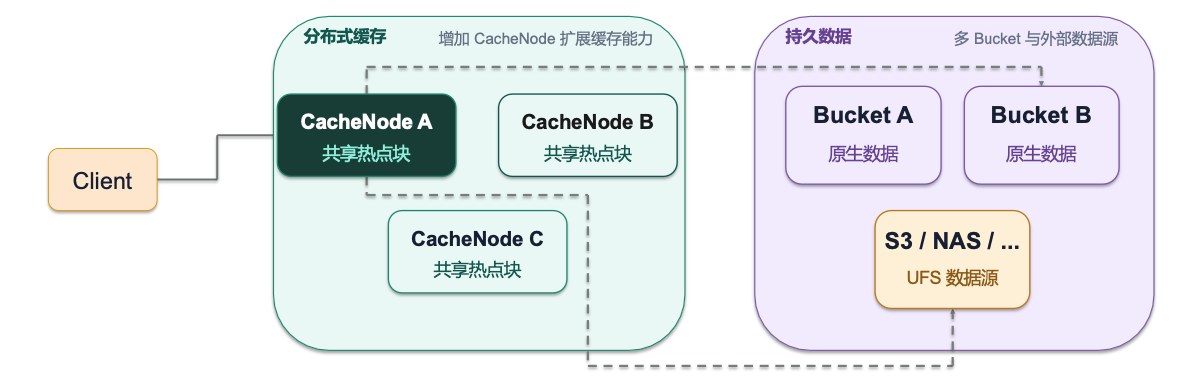
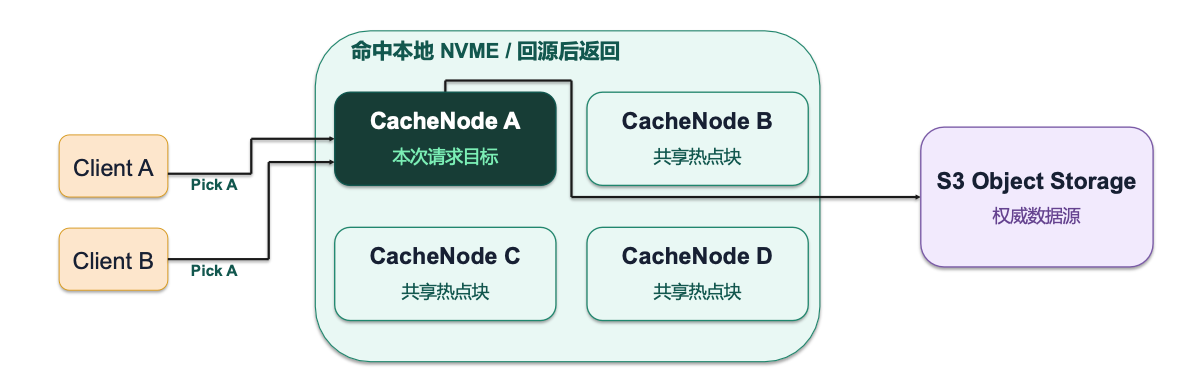
为此,我们基于社区版开发了分布式缓存能力,多个客户端可以复用共享缓存中的热点数据,对象存储始终作为权威数据源,读取流程如下。
- 客户端通过一致性哈希选择目标缓存节点。
- 缓存节点本地盘命中时,直接返回数据。
- 未命中且允许回源时,由该节点从 S3 读取数据,返回后在缓存节点保留一份。
客户端本地缓存仍然可用,与分布式缓存形成多级缓存架构。
UFS(Under File System):外部数据接入与缓存加速
我们还基于社区版开发了 UFS 能力,将外部数据源纳入 JuiceFS 的命名空间。UFS 负责外部数据的统一访问和缓存加速,权威副本继续保留在原系统中。
例如,已有一批数据存放在 S3 中,希望使用 JuiceFS 的缓存加速,就可以将其映射到 JuiceFS 的某个路径下。原始数据无需迁移,业务通过映射后的路径访问即可。
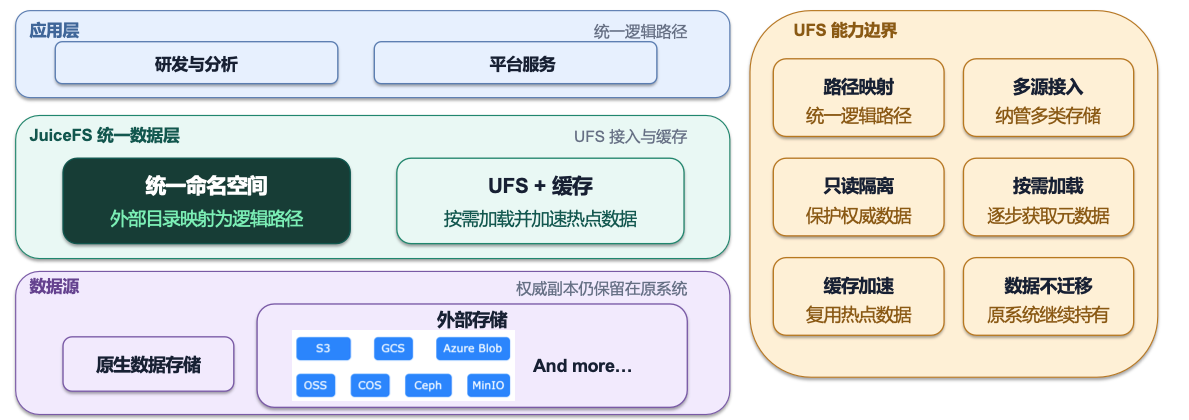
当前映射采用只读方式,支持的后端存储类型与社区版已有的后端支持保持一致。元数据可以按需加载,也可以提前预热;即使没有预先加载,访问目录时也能按需获取外部存储的目录和文件信息。
05 百 PB 级集群生产实践与优化
我们的线上集群已承载百 PB 级数据,带宽达到百 GB/s 量级,缓存容量达到 PB 级。围绕数据准备和任务读取,我们分别优化了缓存编排、模型配送、网络传输和数据格式。
缓存编排:随回传构建与主动预热
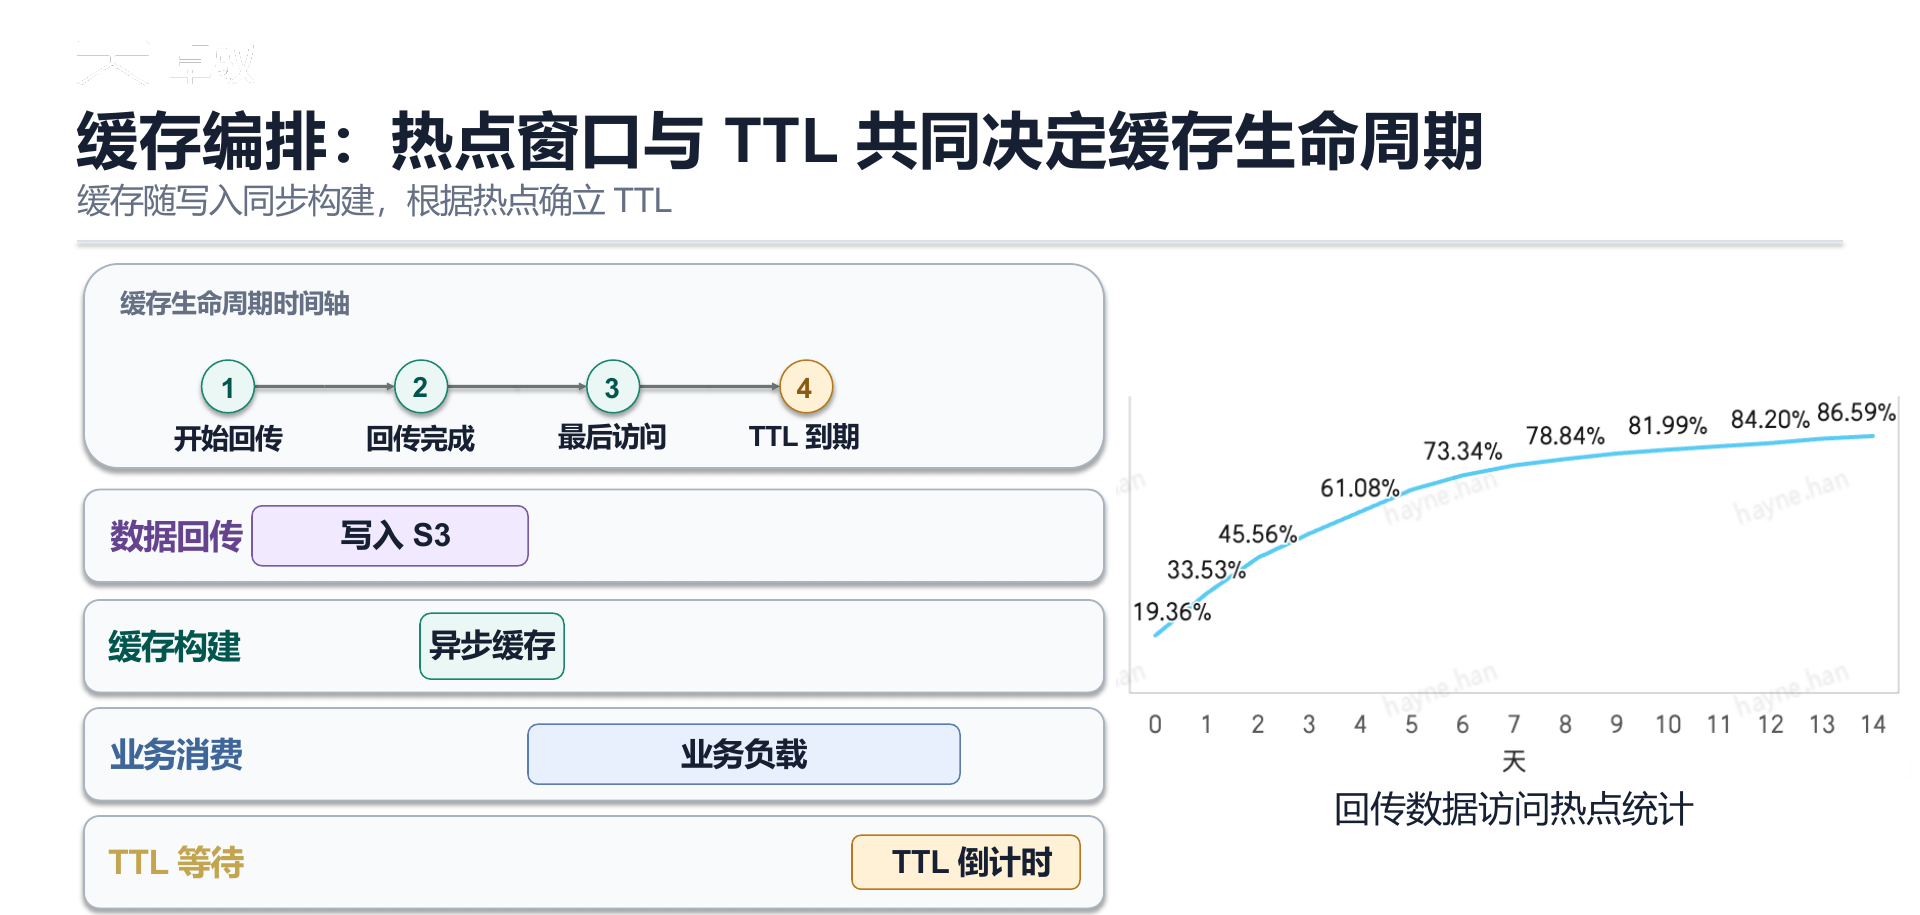
我们通过 SDK 统计发现,约八成数据会在回传后的八天内被使用。因此,我们在数据回传时异步构建分布式缓存,并根据访问规律规划缓存容量和 TTL,使业务读取尽量命中缓存。缓存到期或容量不足时,再进行回收。
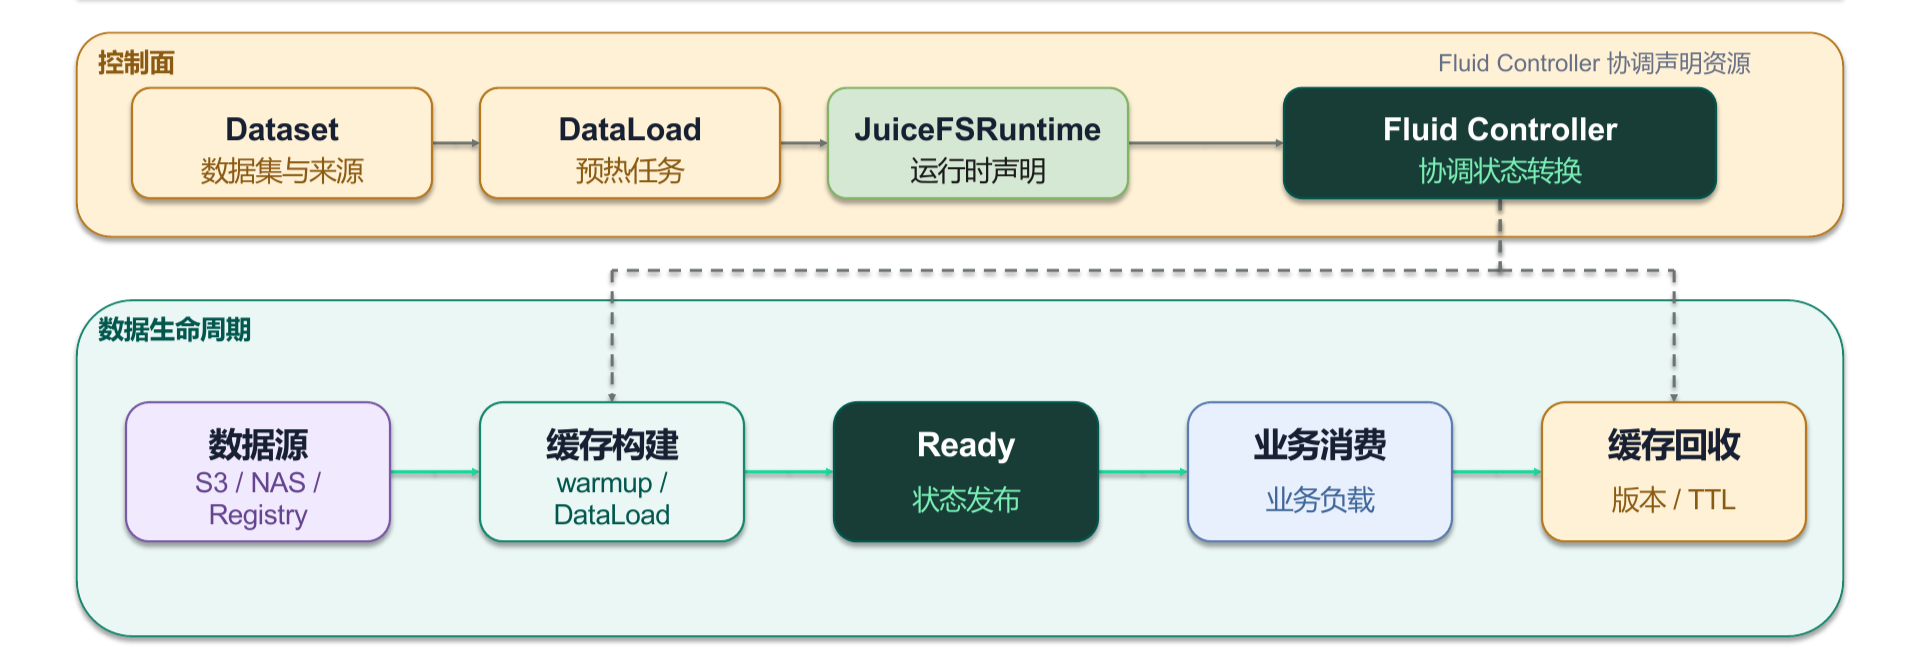
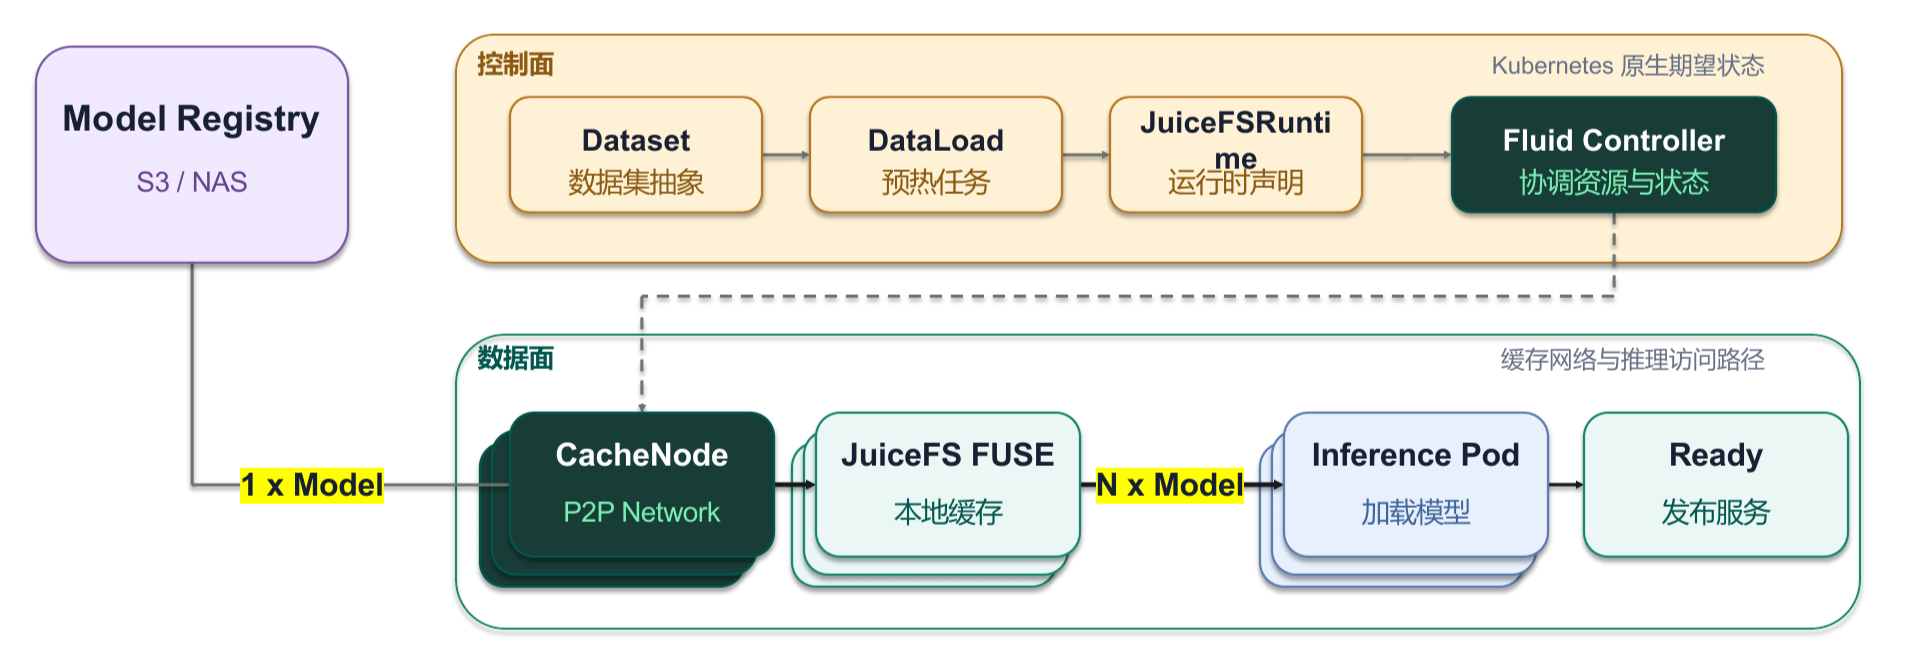
对于需要显式控制数据准备过程的任务,我们引入 Fluid 做主动编排。Dataset 描述数据集及其来源,应用可以通过对应的 Kubernetes PVC 访问数据。
在任务流程中,DataLoad 配合 JuiceFS Runtime 完成预热,数据 Ready 后业务再开始消费。Fluid Controller 协调资源与状态,管理从缓存构建、业务消费到缓存回收的过程。对于未接入 Fluid 编排的业务,我们也提供 API,由业务自行控制缓存预热和淘汰。
推理场景:大规模模型配送
在推理场景中,数据准备主要体现为模型配送:推理 Pod 需要完成模型加载后才能提供服务。之前,Pod 启动时直接从模型仓库加载模型,节点增加后,仓库需要承担大量重复读取。为此,我们将缓存放在模型仓库与推理节点之间。
引入缓存后,模型先预热到分布式缓存,再通过缓存网络分发到各推理节点的本地缓存。同一数据块的请求通过一致性哈希落到同一缓存节点,可以在这里进行 I/O 聚合,减少重复回源。
多个推理 Pod 加载同一模型时,可以通过共享缓存聚合读取请求,将模型仓库的回源数据量尽量控制在一份模型的数据量附近。在内部推理场景中,这套方案使部署速度较原有方式提升了十倍以上。
训练场景:TCP 零拷贝优化
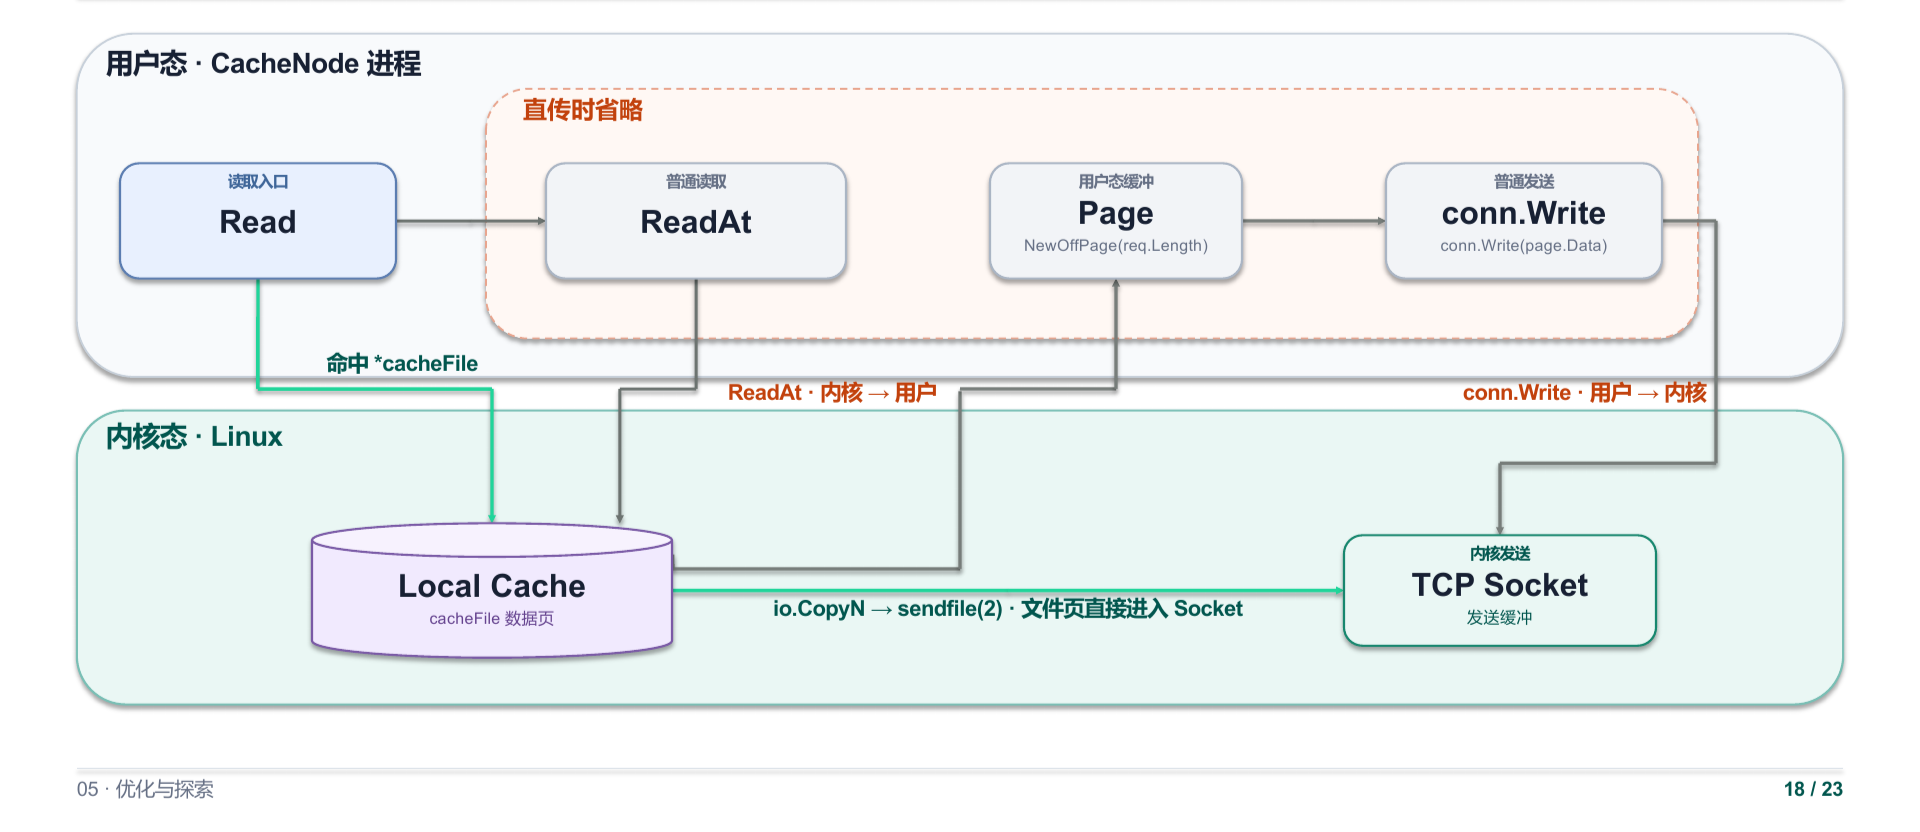
数据进入缓存后,任务仍需要通过网络持续读取。为了减少这一过程中的开销,我们针对客户端与缓存节点之间的数据链路进行了优化,先从适用范围较广的 TCP 网络入手。
普通读取路径需要通过 ReadAt 将数据从内核读到用户态缓冲区,再通过 conn.Write 写回内核发送。在服务端命中 cacheFile、且请求范围有效时,可以通过 io.CopyN → sendfile(2) 将文件数据直接送入 TCP Socket,省去这段用户态中转。
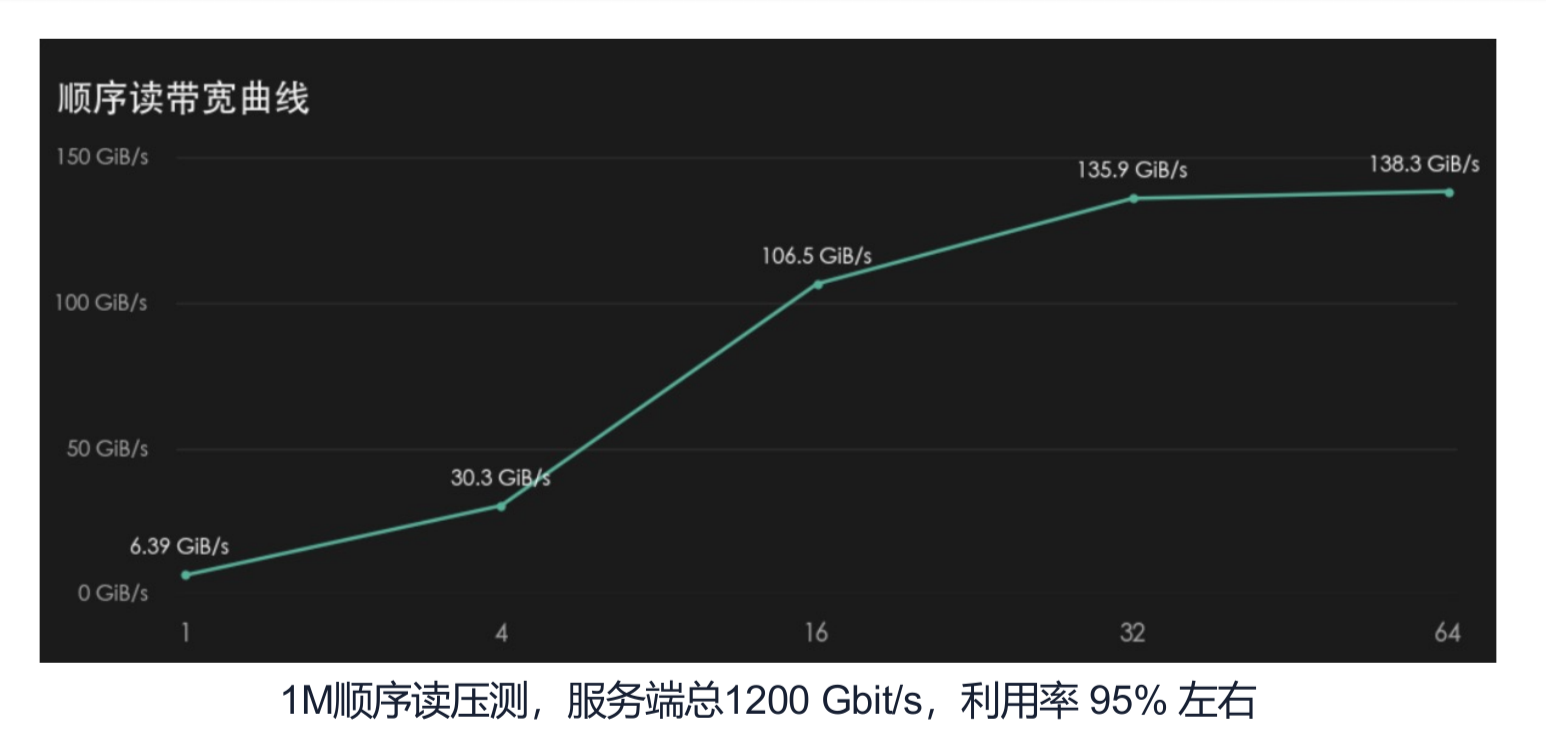
为评估优化后缓存链路的整体性能,我们进行了 1M 顺序读压测。多服务端总带宽为 1200 Gbit/s,实测随着客户端负载增加,吞吐达到约 135–138 GiB/s。吞吐在约 135 GiB/s 时,1M 请求的 P99 时延约为 2 ms;继续提高到约 138 GiB/s 时,P99 时延升至约 20–30 ms。这说明接近带宽上限时,仍需在吞吐与尾延迟之间取舍。
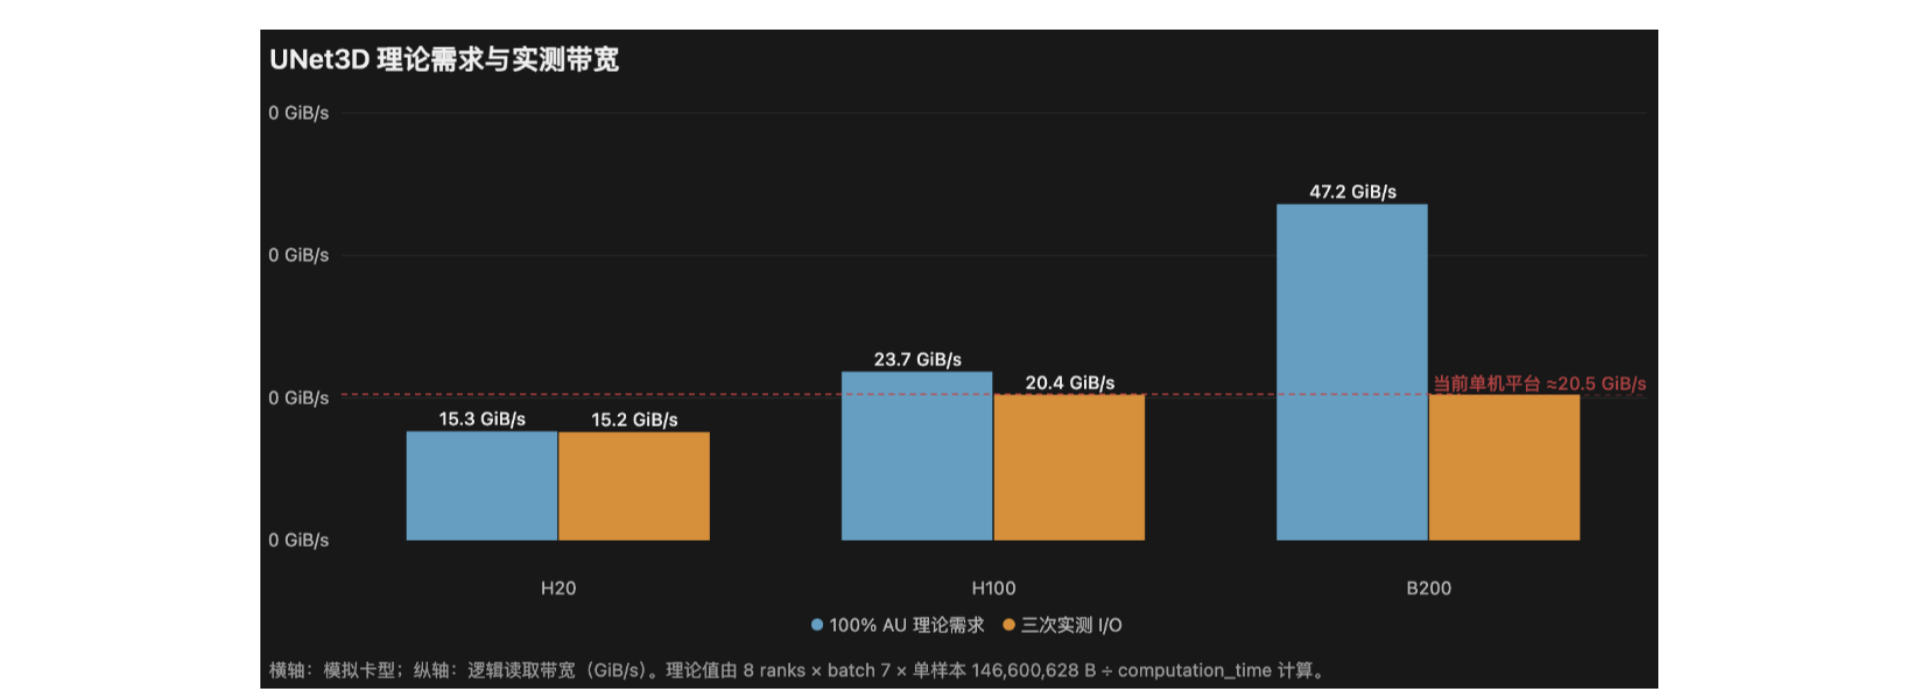
在 MLPerf Storage UNet3D 吞吐型负载中,我们首先采用单客户端高密度拓扑,将 8 个 accelerator rank 的并发读取压力集中到单节点、单条 200 Gbit/s 数据入口,验证单客户端的数据供给上限。测试覆盖 H20、H100 和 B200 三档负载;其中 H100 和 B200 已触及 200G 网络及客户端读取链路上限,瓶颈由后端存储转移至客户端数据入口。下一阶段将把 UNet3D 训练负载扩展至多客户端,并结合 RDMA,进一步验证大规模多机多卡训练下的持续供数能力与加速卡利用率。
Lance 列存储:从数据格式层面减少 I/O
除了提高存储链路的吞吐,我们也通过调整数据格式,减少业务实际需要读取的数据量和 I/O 次数。
以标注数据为例,同一个资产可能对应多个 JSON 文件,之前会将它们打成 tar 包存储。下游处理时仍需要逐帧解析 JSON,进行重复序列化和格式转换,产生大量小 I/O。
我们将标注数据切换为 Lance,把下游常用的 JSON 字段展开为列。数据通过 Arrow Batch 在内存中传递,批量写入 Lance Table,下游按需选择列并批量读取,减少无关字段读取、逐帧 JSON 中转和重复序列化。
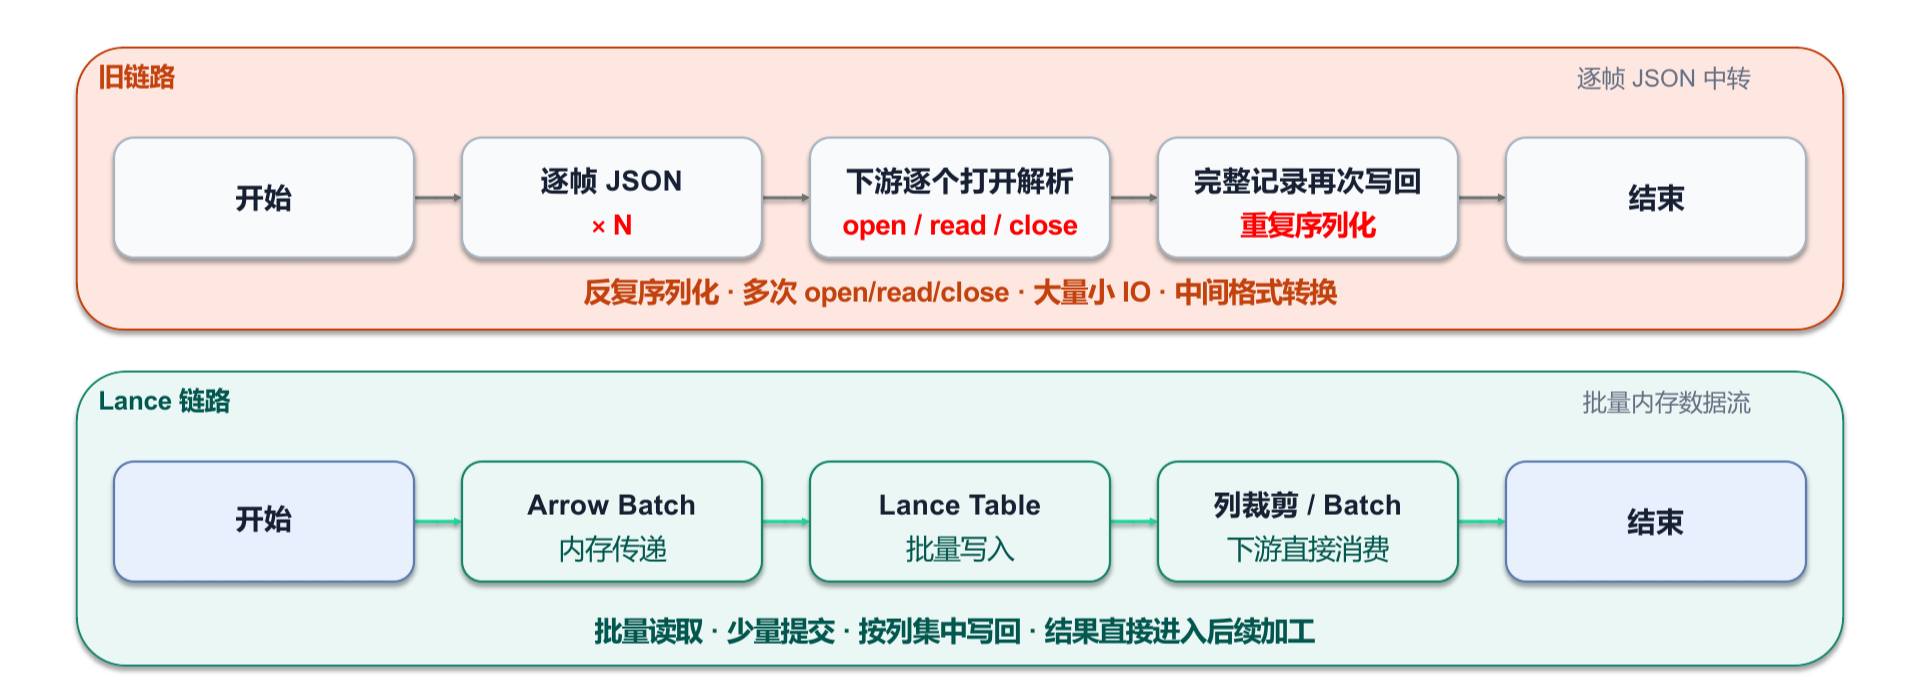
不同流水线的收益有所差异:I/O 耗时下降约 20%–90%,IOPS 需求下降约 90%,带宽消耗下降 60% 以上,大幅降低了业务负载对存储资源的需求。
Lance 与 JuiceFS 结合预热
按列读取也为预热提供了更精确的范围。我们通过 Lance Manifest 等布局元信息定位所选列的物理字节区间,再映射到相交的 JuiceFS 数据块,只预热相关块,减少无关数据读取。
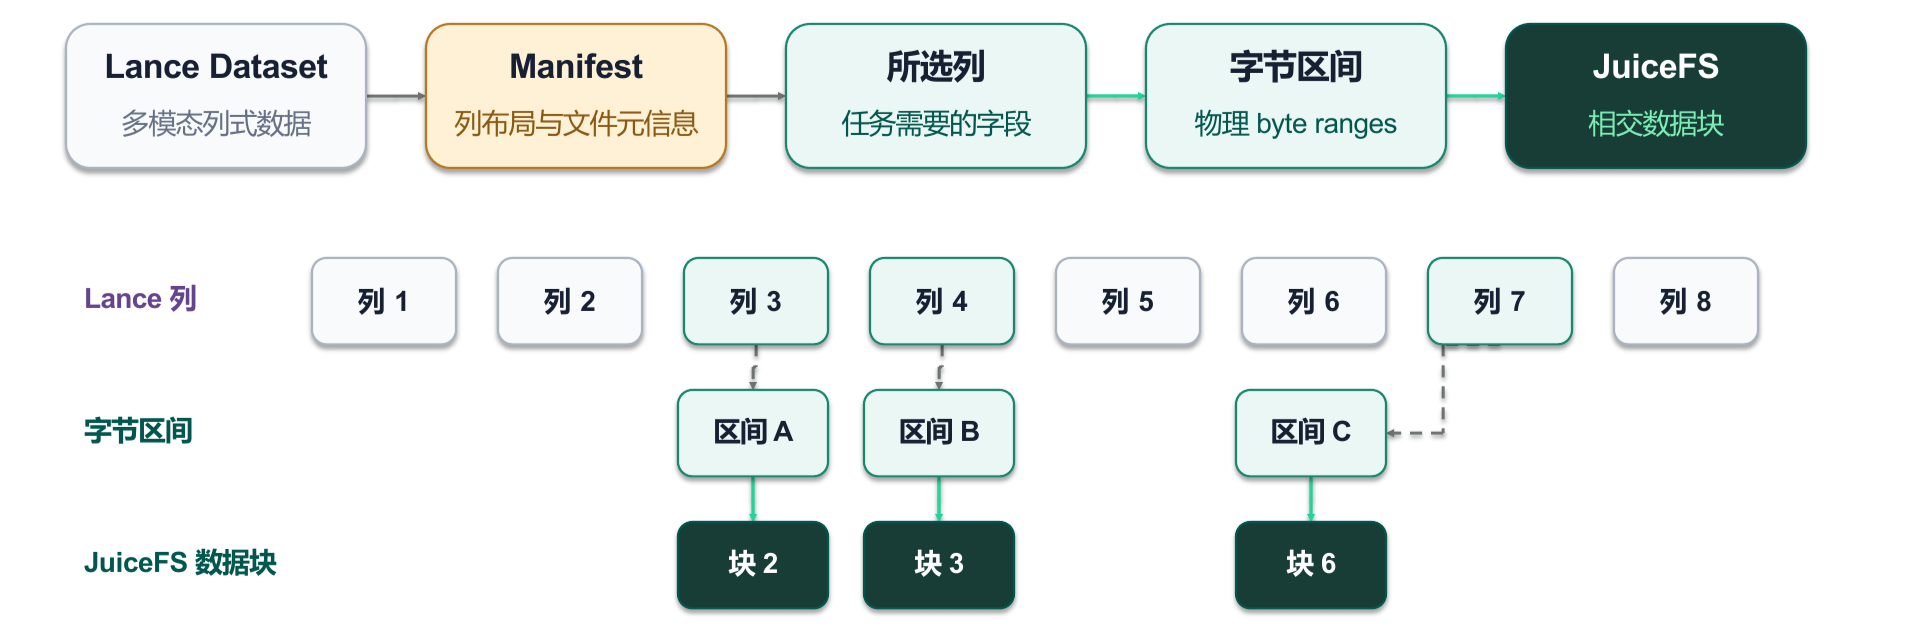
相关能力已合并至 JuiceFS 社区版:按字节范围预热(PR #7398),以及独立的 Lance 数据集解析工具(PR #7399)。两者配合,可根据指定的数据集版本和列,生成文件及字节范围列表,用于按需预热。
06 总结
回顾这次实践,我们以 JuiceFS 为统一数据底座,沿三条路径逐步演进:
稳定入口:通过统一访问层屏蔽底层存储差异,使存储扩容和部署调整尽量不影响业务接入。
共享热点:通过分布式缓存跨节点复用数据,减少任务迁移、扩容和多副本读取中的重复回源。
主动就绪:通过 Fluid 编排和 API 控制,让数据在业务消费前完成准备,以数据就绪状态衔接任务运行。
这三条路径共同支撑了百 PB 级集群上的数据交付,百 GB 级以上的性能需求,也降低了存储运维与业务协同成本。目前,我们仍在持续优化缓存编排、网络传输和数据格式,让数据更快就绪、减少算力等待,为智驾研发提供更稳定的存储底座。