继 JuiceFS 企业版 v5.3 支撑千亿文件规模之后,v5.4 进一步在超大规模场景下提升多项能力。千亿文件规模下,单次操作的细小开销也会累积成显著的资源负担,元数据分区部署后需要协调不同节点,兼顾性能、数据一致性与稳定性。围绕这些问题,v5.4 版本包含下面多项新功能和改进:
- 百万客户端同时挂载;
- 海量文件规模的目录克隆;
- RDMA 带宽利用率超 90%;
- 高并发随机读性能提升 100%;
- 镜像文件系统支持数据按需同步;
- 丰富缓存策略,适配更多业务需求;
- 多项针对大规模数据的运维管理优化。
01 支撑百万客户端接入
随着 Agent 走向规模化,JuiceFS 团队需要解决一个新的难题:在千亿文件的管理负载之上,承接百万客户端的连接与并发访问。团队为此进行了持续探索与优化,并在企业版 v5.4 中发布这项能力。
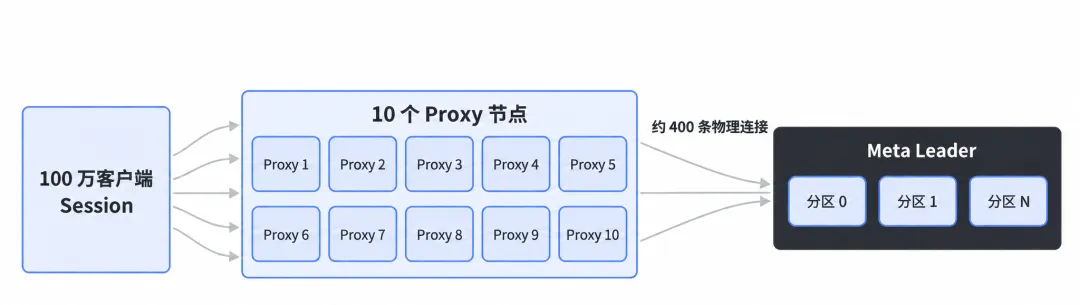
JuiceFS 采用元数据多分区分布式架构,将千亿规模文件的元数据分布到多个 Metadata 节点进行管理。为让这些节点同时承接大规模客户端连接,v5.4 将 Metadata 节点与网络代理(Proxy)合并部署,使客户端可以连接到任一 Metadata 节点。接入节点直接处理本分区请求,涉及其他分区的请求会内部转发至对应节点。多个客户端会话共用节点间的物理连接,减少连接数量及维护开销。
除连接复用之外,大量客户端会话的查询、状态上报和过期清理也需要控制开销。v5.4 通过索引定位客户端会话,减少对无关会话的遍历;通过分页查询和采样上报控制状态管理开销;对过期会话分批清理,避免单轮清理工作过于集中。
经过上述优化,JuiceFS v5.4 在压测中成功支撑了百万客户端同时接入。原先客户端分别连接多个 Metadata 节点,所需连接总数达数千万条。优化后,10 个内部 Proxy 节点承接百万条客户端连接,并通过连接复用,Proxy 到 Metadata Leader 仅需约 400 条后端物理连接,大幅降低了 Leader 的连接维护压力。
02 快速克隆大型目录
用户在为训练数据创建分支或准备测试环境时,往往需要一份可独立修改的目录副本,当目录规模进一步扩大时,克隆本身也会变得更加复杂:对于采用多分区架构管理超大规模数据的用户,一棵目录树的元数据可能分布在多个 Metadata 分区上,克隆需要协调不同节点上的子树复制,保持完整的目录层级关系。
v5.4 实现了跨分区目录克隆,通过递归处理各子树,保留原目录树的跨分区布局。克隆只要复制元数据,底层对象数据继续共享,无需复制;对副本的后续写入不会改变源文件的内容。
在 30 个 Metadata 分区部署中,克隆 1 亿文件耗时 1 分 40 秒,平均速度为每秒 100 万个文件。更多分区可以提供更高的并行处理能力,实际速度也受 Metadata 负载及目录树跨分区间分布情况影响。
需要注意的是,跨分区目录克隆没有保证原子性。如果克隆期间源目录有持续的新数据写入,新克隆目录中的不同子树可能反映源目录在不同时间点的状态。对一致性有严格要求时,需要暂停后再执行克隆。
03 性能提升
RDMA 高带宽传输利用率超过 90%
JuiceFS v5.3 开始支持在客户端与分布式缓存节点之间使用 RDMA,降低数据传输的 CPU 开销,提高传输效率。v5.4 继续提升带宽利用率、传输稳定性等多方面表现。
在客户端配备 400 Gbps RDMA 网卡、分布式缓存节点配备 800 Gbps RDMA 网卡的测试环境中,单客户端读取带宽达到 45 GB/s,单个分布式缓存节点可提供 90 GB/s 的数据服务带宽,网卡利用率达到 90% 以上。
提升高并发随机读 IOPS
在多进程训练、HPC、渲染等场景中,高并发随机读不仅考验存储和网络能力,客户端的锁竞争与请求处理开销也可能限制 IOPS 的提升。
过去半年,JuiceFS 团队通过简化高频处理逻辑、降低锁竞争,持续优化高并发随机读性能。优化后,随机读 IOPS 较此前整体提升一倍以上:使用分布式缓存时,单客户端最高达到 18.9 万 IOPS;使用本地缓存时,单客户端最高达到 15.6 万 IOPS。
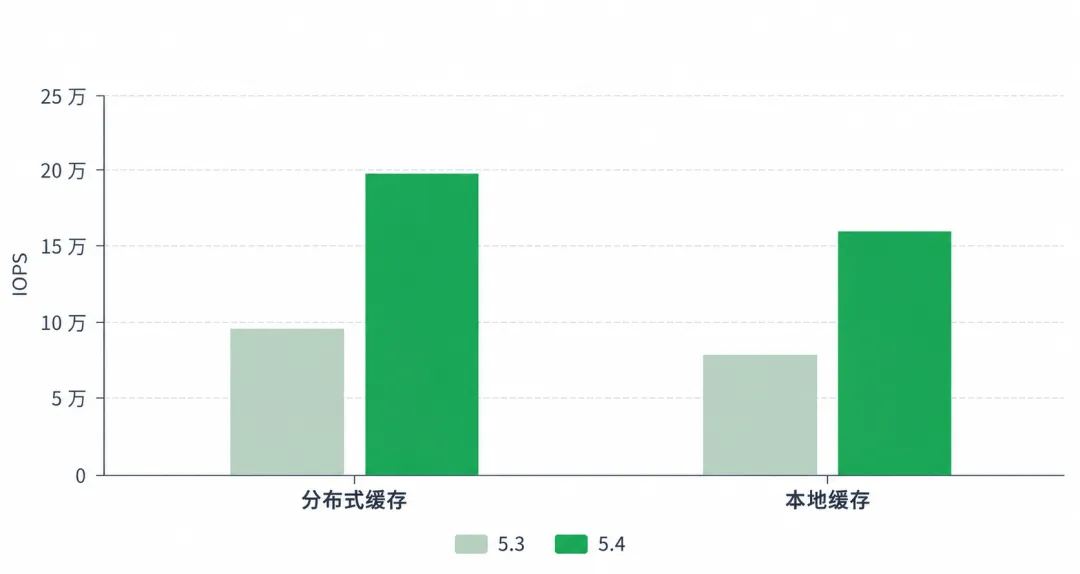
测试环境:双路 AMD 服务器(128 核、256 线程),配备 1 TB DDR4 内存、100 Gbps 网卡及 3.84 TB NVMe SSD(缓存盘);内核版本为 Linux 5.14。
04 多地域数据访问优化
按需同步,减少数据复制
在多地域、多供应商、多集群的算力场景中,部署 JuiceFS 镜像文件系统后,镜像端能够自动同步源端的文件和目录。镜像端持续同步元数据,跟进目录结构和对象版本变化;此前,对象数据默认由后台全量同步。
但镜像端的业务可能只需要源端的一部分模型、样本或历史目录。例如,源端有 10 PB 数据,镜像端只访问其中的 1%,全量同步就会传输并保存大量业务用不到的数据。
v5.4 支持镜像文件系统按需同步对象数据。开启后,元数据仍持续同步,对象数据不再由后台自动同步。客户端读取时,优先从镜像端对象存储获取所需数据;如果数据尚未同步,则从源端拉取,并按需保存在镜像端,从而减少不必要的数据传输与存储。
如果业务要求首次访问就能获得本地读取性能,可以提前预热相关数据;需要保留完整数据副本的业务,则可继续使用后台同步模式。
通过只读节点加速元数据访问
对于只需加速元数据访问的业务,v5.4 提供了无需创建镜像文件系统的新模式。用户可以在其他区域部署元数据服务节点(只读),为当地客户端加速元数据读取。客户端仍挂载源文件系统,加速节点支持动态扩缩容,便于根据访问需求调整部署规模。
05 更灵活的缓存管理
提升热点缓存命中率
一次性扫描的数据通常很少再次使用,将这些数据写入缓存可能挤出反复访问的热点数据。默认情况下,请求未命中分布式缓存时,缓存节点会从对象存储拉取数据,并将其写入缓存。v5.4 新增 cache-aside(缓存旁路)模式,开启后,未命中的请求改由业务节点直接从对象存储读取,不向缓存节点填充此次读取的数据。
批量增加缓存节点时保证命中率
同时新增多个缓存节点时,读取请求可能被分配到尚未缓存所需数据的新节点,触发对象存储回源。v5.4 新增 --commission 参数。新节点启用后,会保留扩容前的节点映射,在自身缓存未命中时向原节点获取数据,减少扩容期间的回源请求。
减少大容量缓存盘的文件数量
使用大容量缓存盘时,缓存块逐一保存为独立文件,会使缓存盘需要管理的文件数量持续增加。新增的 merge-cache 模式将多个缓存块合并存入大文件,并独立保存索引,从而大幅减少缓存盘上的文件数量。该功能目前处于 Beta 公测阶段。
按字节范围预热文件
如果任务只读取大文件中的一部分内容,预热整个文件会额外占用缓存空间并产生数据传输。v5.4 支持为预热文件指定一个或多个字节区间,只预热与这些区间相交的缓存块,使缓存准备范围与任务实际需要读取的内容相匹配。在此功能支持下,可以对 lance, parquet 等数据格式进行更精准的预热。
06 简化海量文件的运维管理
回收站支持按删除时间恢复
从回收站恢复文件时,用户可能知道误删除发生在哪一段时间,却难以仅凭文件名或关键词准确筛选目标。restore 命令新增 start-time 和 end-time 参数,在原有关键词过滤之外,支持按文件删除时间限定恢复范围。
降低 GC / fsck 内存占用
检查大规模文件系统时,GC / fsck 需要处理大量记录,排序过程可能占用大量内存。v5.4 为这两个命令增加外排模式,利用磁盘参与排序,降低对内存的需求。GC 的外排模式仅允许在 dry-run 下执行,用于检查和评估,不实际删除数据。
通过 Token 白名单限制访问范围
v5.4 支持通过 Token 设置白名单,白名单可以指定为根目录下的若干一级子目录。使用该 Token 的客户端只能访问和修改这些子目录中的内容,从而限定不同团队或任务的数据访问范围。
07 小结:Scale changes everything
v5.3 将 JuiceFS 带入了一个新的规模阶段。与此同时,AI 的发展速度仍在不断刷新我们对数据规模和系统负载的认识。当文件数、客户端数和访问请求量同时进入更高量级后,系统所面临的性能、稳定性、一致性和运维复杂度问题不再彼此独立,而会相互影响,并随着规模扩大进一步放大。
v5.4 进一步解决大规模场景下的系统级工程问题,覆盖客户端接入、跨分区目录、数据读取、镜像同步与缓存管理。云服务用户现已可以直接在线体验 JuiceFS 企业版 5.4,私有部署用户可通过官方渠道获得升级支持。
JuiceFS 已广泛应用于 LLM 与多模态大模型、智驾、具身智能、量化金融等领域。我们会继续和这些前沿企业一起,持续完善 JuiceFS,让基础设施更好地支撑业务发展。