随着多模态 AI 和模型训练规模扩大,AI 数据链路需要处理的数据越来越多,类型也越来越复杂。训练任务可能只需要一部分字段,却要从大规模数据集中筛选和读取;数据分布在不同云和数据中心时,计算节点还可能因为访问延迟而等待。这带来了两个问题:怎样减少不必要的数据读取,以及怎样让需要的数据及时到达计算节点。
01 Lance 和 JuiceFS:分别解决什么问题?
Lance 是一个面向多模态 AI 的开源列式湖仓格式(lance.org),提供列式存储、多模态 Schema、向量索引和版本管理等能力,帮助用户组织图片、视频、文本和 Embedding 等数据。它关注的是:任务需要哪些数据,怎样避免读取无关内容。
以自动驾驶数据为例,一条样本可能包含大量标注属性,但一次训练只会用到其中一部分。采用列式存储后,任务可以只读取需要的字段,减少无效数据读取,也让标注属性的更新和迭代更加灵活。
JuiceFS 是一款面向云原生设计的高性能分布式文件系统,位于业务和对象存储之间,通过 POSIX 兼容接口、本地缓存、数据预热和统一命名空间等能力,为计算任务提供数据访问。它关注的是:需要的数据怎样稳定、及时地送到计算节点。
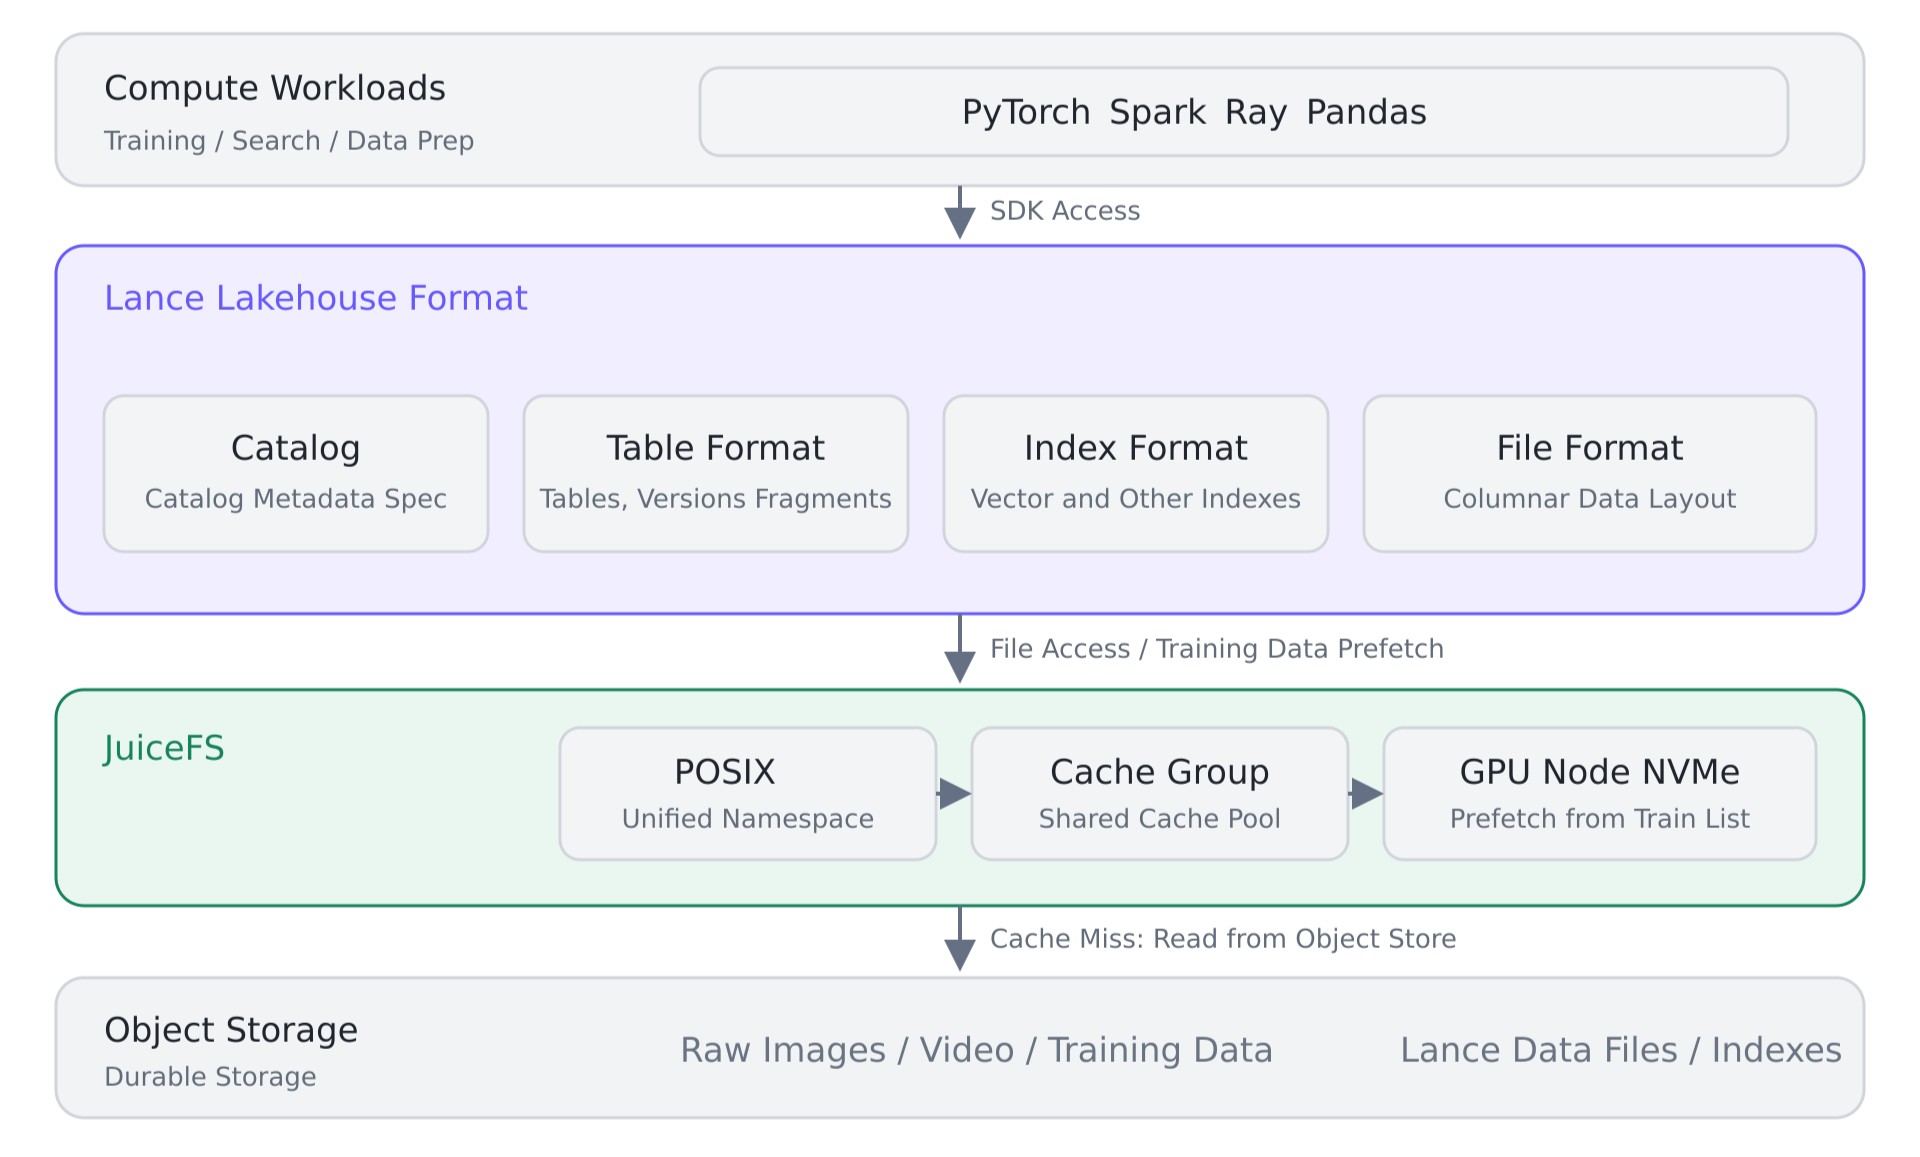
因此,Lance 主要减少“要读多少”,JuiceFS 主要改善“读取要等多久”。
02 有了 Lance,还需要 JuiceFS 吗?
答案取决于具体业务场景,主要看三点:任务是否对延迟敏感、I/O 是否成为主要瓶颈、GPU 等待成本是否足够高。
向量检索、数据标注、离线挖掘场景
在这类场景中,Lance 直接连接对象存储通常已经能够满足需求。
原因主要有两个:
第一,这些任务通常对延迟不敏感。例如离线检索任务,即使增加几十秒等待,对业务影响也有限。
第二,I/O 可能不是主要瓶颈。在某些向量检索场景中,一亿行数据 TOP20000 检索耗时约 20 秒,其中 CPU 向量计算占主要比例,而 I/O 和网络只占较小比例。此时增加缓存,对整体性能提升有限。
数据生产和 GPU 训练场景
当 I/O 成为主要瓶颈时,JuiceFS 的价值更加明显。
GPU 训练与离线检索不同,GPU 节点成本高昂。如果大量 GPU 因等待数据而空转,损失远高于增加一层缓存的成本。尤其是在多云、多 IDC 场景下,GPU 可能需要跨云读取对象存储数据。直接通过网络访问对象存储容易产生高延迟和性能毛刺,影响训练效率。
JuiceFS 的解决思路是把数据提前放到计算节点附近:通过本地缓存和数据预热,让训练启动时优先从本地读取,减少对远端对象存储的直接访问,从而降低跨云延迟和性能毛刺。
03 头部智驾生产案例:Lance + JuiceFS
某头部智驾公司采用了 Lance + JuiceFS + 对象存储的架构,用于支撑大规模自动驾驶数据处理和模型训练。
该场景具有几个典型特点:
- 数据分布在多个云环境和 IDC;
- 标注数据规模达到数十亿行,并持续向更大规模扩展;
- 数据生产和模型训练均存在较高 I/O 压力。
在数据生产阶段,主要问题是读放大。传统流程常使用 LMDB,一条记录中包含大量标注信息,而一次任务可能只需要其中少量字段。如果每次都读取整条记录,就会加载大量当前任务用不到的数据;修改或扩展标注字段时,也可能增加维护成本。
Lance 的列式存储可以让任务只读取需要的字段。原始文件仍保留在对象存储中,Lance 管理索引和相关元数据,从而减少读取量,并支持标注属性的迭代。
在模型训练阶段,主要问题是跨云访问带来的等待。如果 GPU 节点直接读取远端对象存储,网络延迟可能使数据供给跟不上计算。
因此,该公司的架构在 Lance 和对象存储之间增加了 JuiceFS 缓存层:Lance 管理数据并生成 train list,JuiceFS 根据列表将训练数据提前预热到 GPU 节点的本地 NVMe 缓存中。训练启动后,大部分数据可以从缓存读取,未预热的数据再回源对象存储。
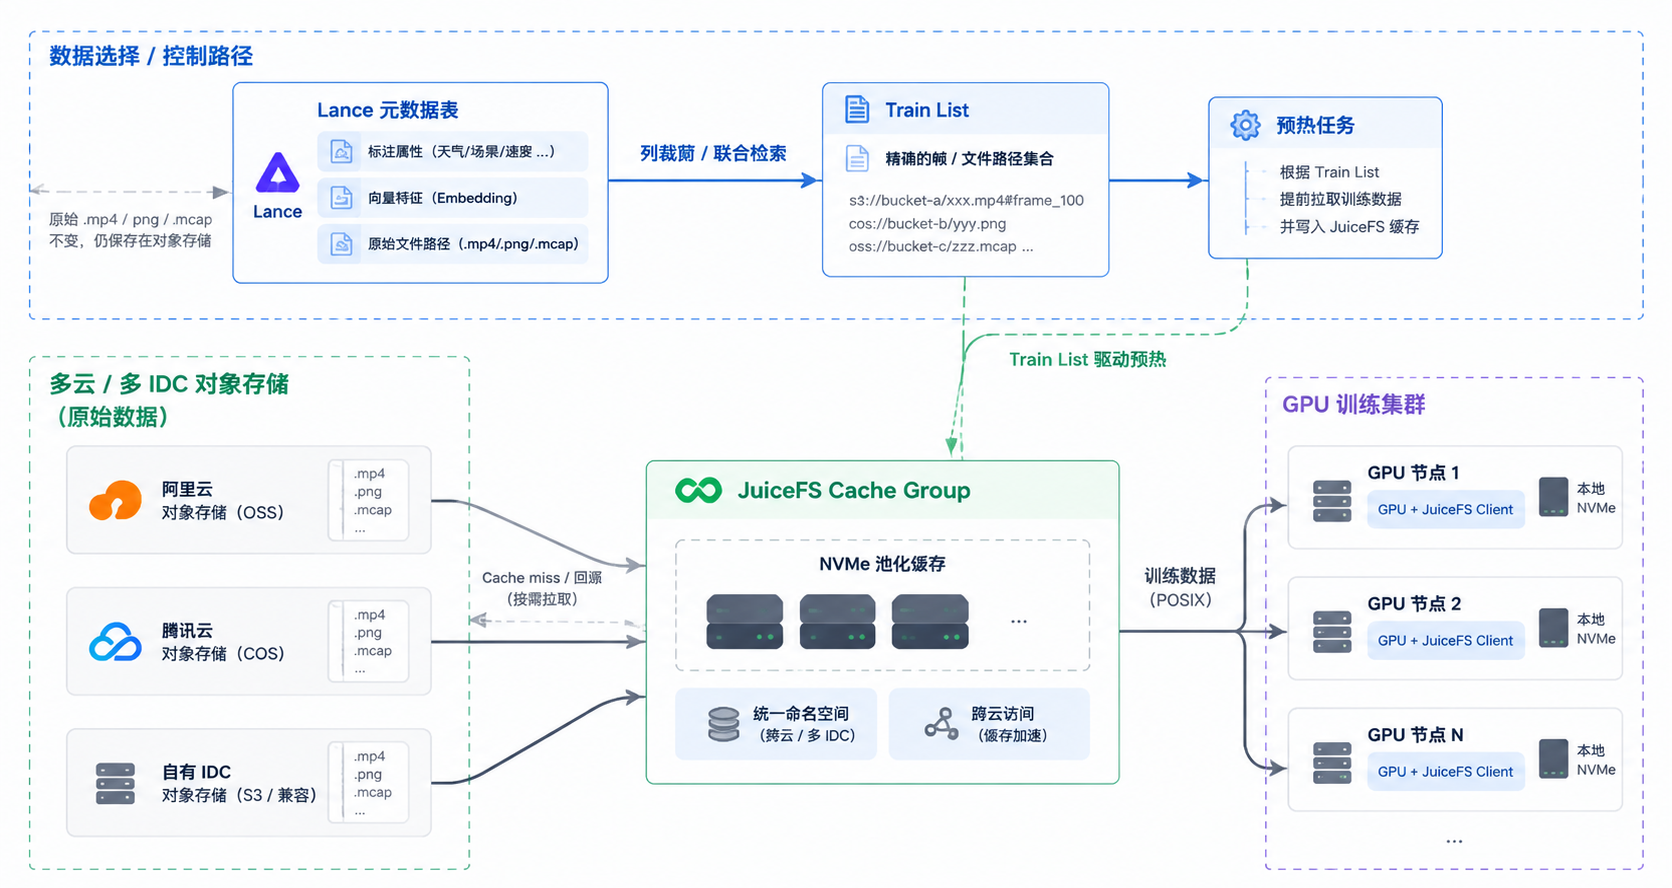
这条链路可以概括为:对象存储保存原始数据,Lance 组织和筛选数据,JuiceFS 将训练需要的数据送到计算节点。
04 小结
Lance + JuiceFS 是否值得组合,关键看两个瓶颈是否同时出现:一是读放大,任务只读少量字段却加载大量无关数据;二是访问延迟,跨云、多 IDC 的 GPU 训练因等待数据而空转。两者同时存在,且 I/O 成为主要瓶颈时,组合价值最明显。
JuiceFS 已开始支持面向 Lance 数据集的精细化数据预热,进一步打通数据组织与缓存加速之间的协作(相关 PR:JuiceFS #7398、JuiceFS #7399)。
Lance + JuiceFS 仍是一个较新的应用组合,公开的生产实践和案例还不多。如果你在业务中有相关落地经验,欢迎联系我们投稿或分享。