HeyGen 是一家 AI 视频生成与数字人平台,用户超过 3,000 万,覆盖 196 个国家,并被 85% 的 Fortune 100 企业采用。其研发、训练和推理任务分布在全球 10 多个 GPU 集群中。随着业务规模增长,如何在不同集群间实现高效的数据共享,成为其存储架构建设中亟待解决的关键问题。
本文分享 HeyGen 团队基于 JuiceFS 企业版的存储实践:通过统一文件命名空间和多级缓存预热,优化推理业务中模型与依赖的分发和加载;同时利用 RDMA 的高带宽传输,结合数据集批次预加载,减少训练过程中的 GPU 等待。
该架构已在生产环境运行一年以上,支撑约 6 PB 数据、约 10 亿个 inode 和 1,000–2,000 个客户端节点。其中,100 GB 模型冷读取时间从 20–30 分钟缩短至 60–120 秒。
01 全球 10+ GPU 集群数据访问挑战
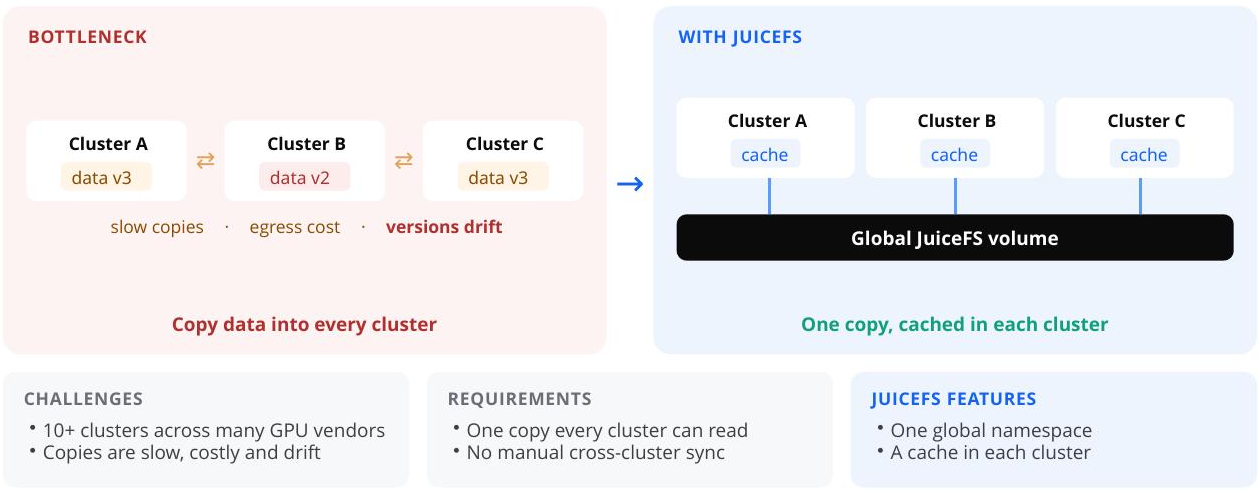
HeyGen 的计算资源来自不同数据中心和 GPU 供应商,任务会根据可用算力在不同集群间动态调度,所需的数据集、模型和依赖未必与计算资源位于同一区域。
如果每个集群都独立维护一份数据副本,就需要在集群间复制或同步数据,不仅耗时,还可能产生额外的网络出口费用。不同集群的数据副本也可能出现版本差异,增加同步和一致性维护的工作量。当算力资源发生变化时,数据还需要随之迁移,进一步增加任务启动和运维的复杂度。
因此,HeyGen 需要一个能够跨云、跨区域提供统一命名空间的文件系统,让不同集群通过统一路径访问数据,而不必由用户手动管理数据副本的流转。
02 存储方案:统一命名空间、跨集群共享与 POSIX 兼容
在选型过程中,HeyGen 考虑过云上和机房 NAS,以及对象存储加数据复制等方案。云上或机房 NAS 虽然能提供文件系统接口,但通常面向单一站点部署,吞吐能力也受存储设备限制。对象存储加数据复制虽然能够提供较高带宽,但跨区域访问延迟、数据复制和同步仍需额外处理。此外,HeyGen 的研发团队主要通过 POSIX 接口访问数据,如果改用对象存储接口,就需要改造现有代码,增加迁移成本。
综合这些因素,HeyGen 最终选择 JuiceFS 企业版:以对象存储作为数据底座,不需要团队自行维护存储节点,减少存储侧的运维负担;同时通过统一命名空间、POSIX 接口和集群侧缓存,满足跨集群数据共享与访问性能需求。
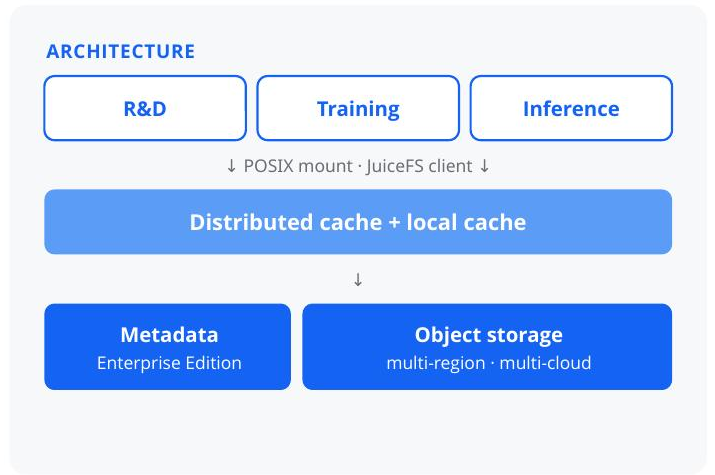
整体架构可以分为四层:
- 访问层:R&D、Training、Inference 等工作负载通过 POSIX 挂载访问文件。
- 缓存层:客户端本地缓存与集群内的分布式缓存共同承担数据读取。
- 元数据层:使用 JuiceFS 企业版管理文件系统元数据。
- 数据层:使用跨区域、跨云的对象存储保存文件数据。
跨集群共享:从独立副本到统一访问
在原有模式下,不同集群可能使用不同版本的数据,例如一个集群使用 data v3,另一个仍然使用 data v2。团队需要额外处理数据复制、版本更新和同步。采用 JuiceFS 后,HeyGen 将多个集群接入同一个全局文件系统,通过统一挂载入口访问数据,并利用各集群的 Cache Group 加速读取,从而减少重复复制和版本同步的工作。
保持 POSIX 访问方式
除了跨集群共享,HeyGen 还希望尽量减少存储变化对应用代码的影响。研发和数据处理代码原本主要通过 POSIX 文件路径访问数据,而不是直接调用对象存储接口。如果改用对象存储访问,就需要额外进行代码迁移和适配。
JuiceFS 保留了文件系统接口,应用仍然可以通过普通路径访问文件,例如:open('/jfs/data/...')
因此,研发人员可以继续沿用原有的文件访问方式,也更容易保持本地开发与线上运行的一致性。对 HeyGen 来说,POSIX 兼容不仅降低了应用迁移成本,也减少了业务代码对底层存储变化的感知。
03 多级缓存架构
统一文件系统解决了不同集群访问同一份数据的问题,但如果任务仍然直接从跨区域、跨云的对象存储读取模型和训练数据,加载速度仍会受到网络距离、传输带宽和并发读取压力的影响。尤其当大量任务同时启动、重复读取相同文件时,数据加载可能拖慢任务启动,甚至让 GPU 因等待数据而闲置。
为此,HeyGen 采用多级缓存架构,将高频访问的数据缓存在更靠近计算资源的位置,减少重复从远端存储读取数据的等待。整体数据访问链路包括以下四个层次:
- 内存:每个节点的读写缓冲和元数据缓存。
- 本地缓存:客户端将读取的数据缓存到节点上的 NVMe 磁盘。
- 分布式缓存:每个集群部署独立的 Cache Group,在集群内共享缓存数据。
- 全局存储:跨区域、跨云的对象存储,保存完整数据,作为共享的数据底座。
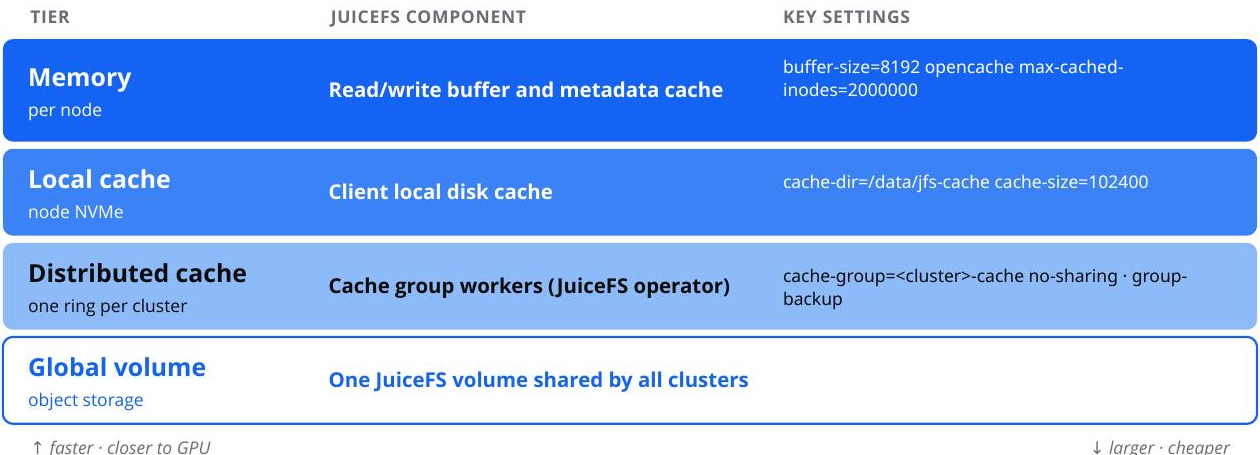
客户端内存中包含读写 Buffer 和元数据缓存。其中,读写 Buffer 是分配给客户端进程的内存,其大小由 --buffer-size 控制,读写操作都会经过这块缓冲区,因此该配置会影响客户端的预读性能和读写并发;元数据缓存则可以减少客户端与元数据服务之间频繁的列表(ls)和查询操作,从而提升元数据访问性能。同时,元数据缓存支持主动失效,以确保强一致性。
在磁盘缓存层,本地缓存服务于单个客户端;而 Cache Group 则将同一集群内多个节点上可用于缓存的 NVMe 组织成分布式缓存,供集群内的 GPU 工作负载共享读取。HeyGen 为每个集群部署独立的 Cache Group,而所有集群仍通过同一个全局 JuiceFS 文件系统访问完整数据。
在这套架构中,如何在有限的缓存空间内优先保留高频访问的数据,是提升缓存利用效率的关键。JuiceFS Cache Group 支持按目录或文件设置缓存优先级;缓存空间不足时,优先级越高的数据越晚被淘汰。
除了通过缓存优先级控制数据的淘汰顺序,HeyGen 还会使用 warmup,将已知任务即将使用的数据提前加载到 Cache Group,减少任务启动后的首次读取等待。
接下来,我们以模型与 Python 依赖分发、训练数据加载为例,介绍 HeyGen 如何根据不同工作负载运用这套多级缓存架构。
04 实践一:模型与 Python 依赖分发
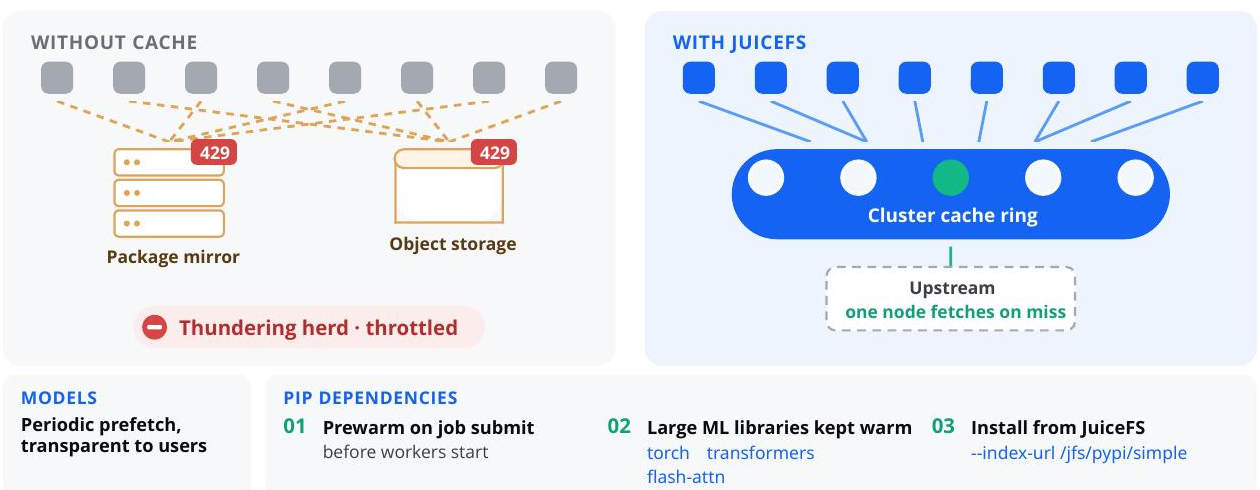
训练或推理任务启动时,在读取数据集之前通常需要加载模型和安装 Python 依赖。当大量任务实例同时启动时,如果每个实例都分别从上游存储或 Python 镜像源获取这些文件,启动速度就会受到网络条件和上游服务性能的影响。
HeyGen 希望在任务从单机扩展到数千个节点时,仍尽可能保持原有的开发体验。实际的数据处理需求变化较快,一天可能需要同步数十个版本;如果每次变化都重新构建和分发 OCI 镜像,不仅会增加开发流程复杂度,也会增加使用者的心智负担。因此,HeyGen 没有把所有依赖变化都转化为 OCI 镜像,而是继续保留原有的 Python 依赖安装方式。
基础设施需要解决的问题也随之变成:在尽量不改变现有开发方式的前提下,如何让不同集群中的任务快速获取相同的模型和 Python 包。
模型缓存与预热
模型文件通常体积较大,任务启动时需要加载,也可能被多个任务重复使用。为了减少首次读取带来的等待,HeyGen 会将模型文件设为较高的缓存优先级:/demo/models:缓存优先级 3;
同时,团队定期将高优先级模型预热到 Cache Group,让任务启动时优先读取已经准备好的缓存数据。客户端侧还结合 Page Cache 与 Prefetch 优化模型读取链路。
模型预热的具体配置如下:
juicefs mount models /mnt/jfs-warmup
  --cache-group=$CACHE_GROUP
  --no-sharing
  --group-network=$NIC
  --cache-size=0
  --buffer-size=8192 -d

juicefs warmup
  /mnt/jfs-warmup/models
  -c 64
  --cache-priority=3
预热任务按小时运行。其中,--cache-size=0 使预热进程将数据填充到 Cache Group,而不占用自身的本地磁盘缓存。
Python 依赖分发
Python 依赖同样会被不同任务反复使用,但缓存空间有限,团队需要在模型和依赖之间分配缓存资源。因此,Python 依赖的缓存优先级低于模型:/demo/deps:缓存优先级 2
其他数据的缓存优先级则设为 0。这样,当缓存空间不足时,系统会优先保留模型,其次是常用 Python 依赖,其他数据则更早被淘汰。
为了避免每个任务启动时都分别下载依赖,HeyGen 会提前将 Python 包放到 JuiceFS 路径中,并在任务提交时预热所需依赖。安装时,任务将索引地址指向该路径,例如:--index-url /jfs/pypi/simple
不同集群中的任务可以通过统一的 JuiceFS 路径访问相同依赖。缓存未命中时,节点从上游获取文件,其他工作负载则可以复用集群内已有的缓存,减少重复拉取造成的上游压力,也降低了各集群分别维护外部 Python 镜像源的需求。
在 1,000+ 并发场景中,HeyGen 对模型和 Python 依赖加载进行了测试,结果如下:
- 100 GB 模型冷读取:从约 20–30 分钟缩短至 60–120 秒。
- uv 依赖安装:从约 5 分钟缩短至约 30 秒。
具体效果会随工作负载和运行环境变化。对 HeyGen 来说,更重要的是,模型和依赖的分发不再完全受各集群外部网络条件影响,高频使用的数据可以提前准备在靠近计算资源的缓存中,从而减少任务启动阶段的等待。
05 实践二:训练数据加载与减少 GPU 等待
与模型和依赖分发关注任务启动不同,训练场景更关注训练过程中数据能否持续供给。训练数据可能存放在一个区域,而训练任务运行在另一个拥有大规模 GPU 资源的集群中。如果数据加载跟不上训练节奏,GPU 就可能因等待数据而闲置。
针对这一问题,HeyGen 利用训练节点上的 NVMe 构建更大规模的 Cache Group,并结合 RDMA 和批次预热,减少数据读取开销和 GPU 等待时间。
利用训练节点 NVMe 构建大规模缓存
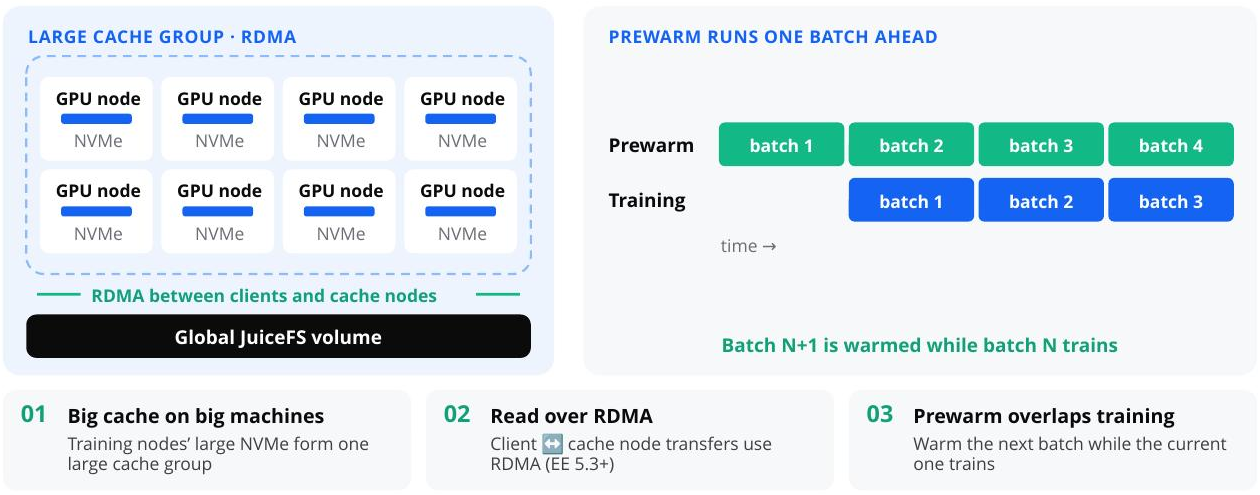
训练节点通常具有较大的本地 NVMe 空间。HeyGen 将这些 NVMe 资源组织为集群级 Cache Group,使训练任务能够优先从集群内缓存读取数据。
为了提高客户端从 Cache Group 读取数据时的传输效率,团队使用 RDMA 加速客户端与缓存节点之间的数据传输。该能力适用于 JuiceFS Enterprise Edition 5.3 及以上版本,客户端和缓存节点两端都需要配置相应的 rdma-network。在 HeyGen 的实际运行环境中,Cache Group 与 RDMA 配合后,缓存读取基本可以打满网卡带宽。
除了提高缓存读取速度,HeyGen 还希望尽量让数据加载不阻塞训练过程,因此进一步将下一批数据的预热与当前批次训练重叠。
提前加载下一批训练数据
HeyGen 的训练数据按批次使用。当训练任务正在使用第 N 批数据时,预热任务会利用暂时空闲的带宽,提前将第 N+1 批数据加载到 Cache Group:
- 训练任务读取并处理第 N 批数据。
- 同时,预热任务提前加载第 N+1 批数据。
- 第 N 批训练结束时,第 N+1 批数据已经在缓存中准备就绪。
- 训练继续进行,同时再预热后续批次的数据。
这样,数据加载可以与当前批次训练并行进行,减少训练等待,并降低因数据 I/O 造成的 GPU 空闲时间。此外,已完成训练任务的数据会被新加载的数据自动淘汰,从而更有效地利用有限的缓存空间。
06 小结
总体来看,HeyGen 通过统一命名空间、POSIX 兼容和分层缓存,解决了跨云多集群环境下的数据共享、应用迁移和负载冷启动效率问题。整体收益主要体现在三个方面:
- 启动与训练等待减少:模型和 Python 依赖可以提前预热,训练场景可以提前加载下一批数据,减少冷读取和 GPU 等待。
- 数据管理与运维简化:多个集群通过统一命名空间访问数据,减少数据复制、版本同步和多集群运维。
- 存储成本更可控:以对象存储为数据底座,通过多级缓存承接高频访问,兼顾存储成本和访问性能。
对多云、多 GPU 集群的 AI 基础设施而言,将统一命名空间、POSIX 兼容与分层缓存结合起来,有助于兼顾跨集群数据共享、应用兼容与数据访问效率。欢迎存储与 AI Infra 领域的同行交流,分享在数据共享、模型分发和训练数据加载方面的实践与经验。